PhAI Labs · 技术
面向科学发现的技术体系
PhAI Labs 的技术工作围绕一个问题展开:如何让 AI 系统参与真实的科学发现。DFM 是我们为此提出的研究范式;ScienceBuddy、ScienceIDE 与 JEPA-Anything 是三个彼此独立的研究与工程方向,分别从交互反馈、可复用的科学环境和世界状态预测展开。
- 科学问题
- 模型训练
- 工具调用
- 真实实验
- 外部证据
- 能力提升
01PhAI 的技术方向
今天的 AI 已经能够检索文献、生成代码、处理数据并辅助完成部分科研任务。但真正的科学发现,往往始于一个尚未被清晰定义的问题,并经历假设形成、证据组织、工具调用、实验验证以及持续修正。这些过程无法只在标准数据集或封闭任务中完成。
公开数据已经见底。模型训练最缺的不是更多文本,而是带有真实结果的科学数据:一个假设被验证或被推翻,一个实验成功或失败。这样的数据无法从网上抓取,只能在真实科研过程中产生。
因此我们把方向定在科学智能本身:让系统从真实任务和环境反馈中持续学习、验证并改进。数据训练模型,模型设计下一个实验;实验返回的每一个结果,包括失败,都成为下一轮训练的信号。这是 PhAI Labs 长期关注大模型、强化学习、智能体与科学智能的原因,也是 DFM 的出发点。
02DFM · Discovery Foundation Models
围绕 Discovery Intelligence 的研究范式
DFM(Discovery Foundation Models)不是一个单一模型,也不是要求所有系统按同一套流程运行的软件框架,而是 PhAI Labs 围绕 Discovery Intelligence 提出的一套研究范式、能力定义和系统组织方式。它通过形式化定义、流程图示、系统实例和真实科学案例,把“发现”从一个模糊概念具体化为一种可学习、可执行、可评测的模型系统能力。
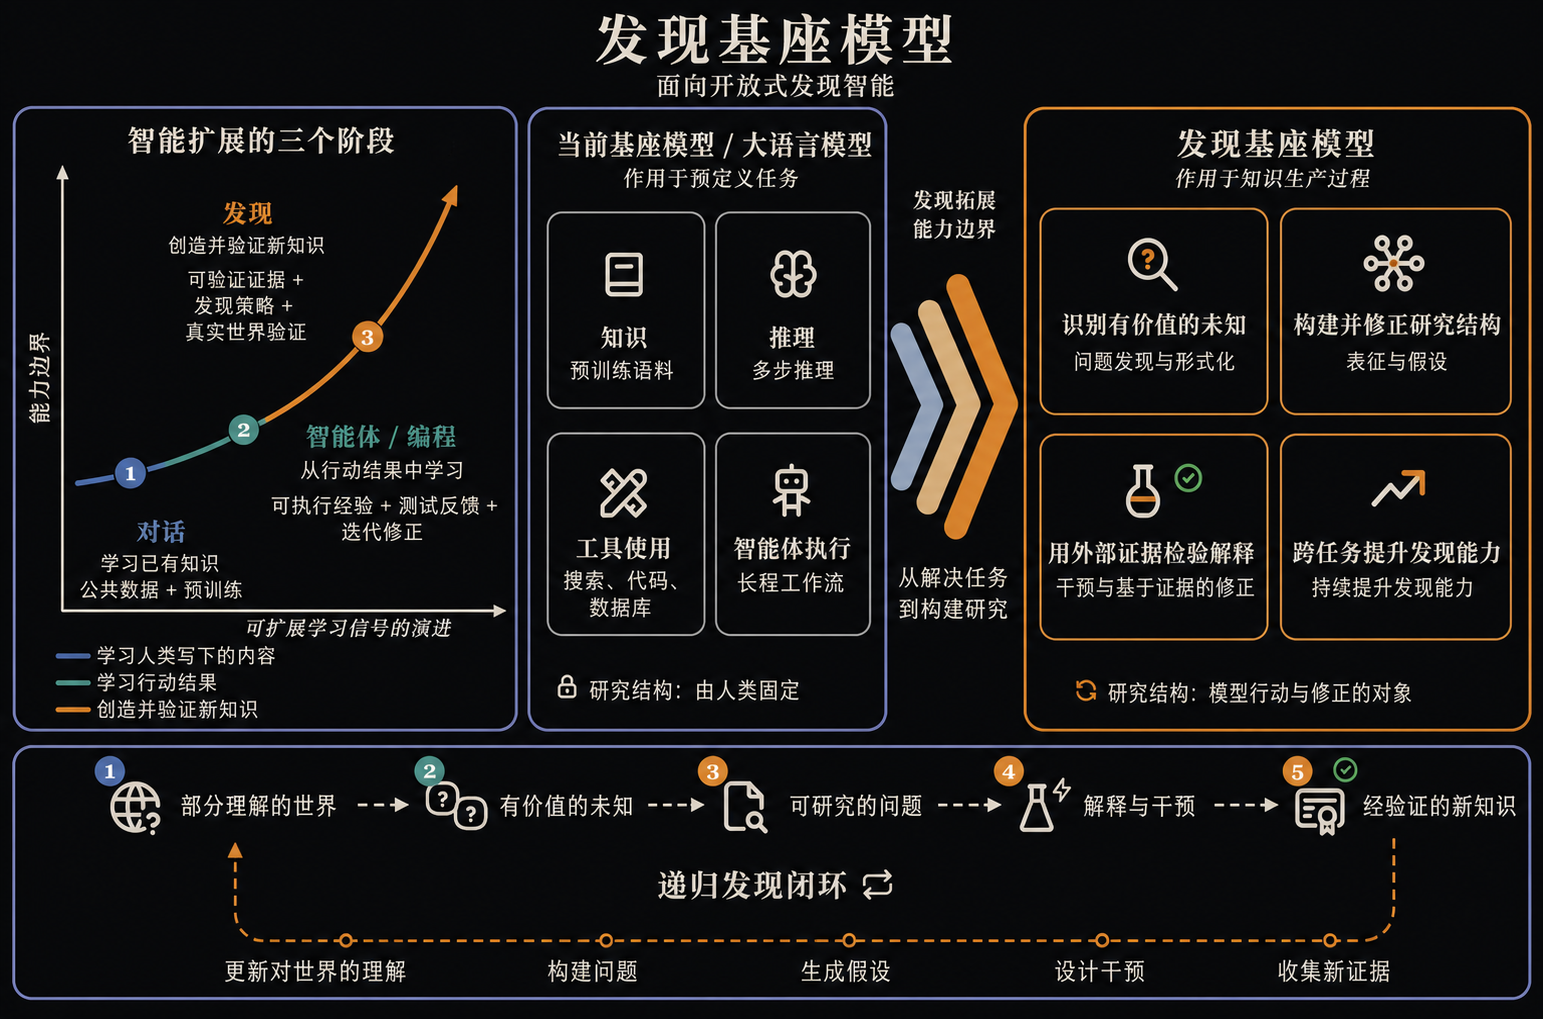
DFM 不是一个模型,也不是要求所有系统按同一套流程运行的软件框架。它是一套范式、能力定义和系统组织方式:说明科学发现过程里有哪些能力、它们如何相互连接,以及哪些环节需要外部证据。
在这一过程中,科学问题是起点。系统从一个部分理解的世界出发,识别有价值的未知,把它转化为可研究的问题,再围绕问题构建假设。假设不停留在文本里:系统调用科研工具、数据和实验环境去执行,从数据分析、实验结果和专家判断中获取外部证据,并据此验证、修正或推翻自己的判断。
模型训练嵌在这个过程之中。每一次工具调用、每一次实验反馈,都是对模型判断的一次检验,也是一份带有真实结果的训练信号。经过验证的新知识、可复用的问题、工具与验证机制沉淀下来,成为下一次发现的起点。
围绕这一范式和能力定义,相关研究将通过系统实例、独立论文、工程模块和真实科学合作逐步展开并陆续发布。这些工作不构成一套唯一的固定实现架构,而是从不同方向探索如何让 Discovery Intelligence 变得可操作。
DFM 让 AI 走完一整圈发现:从找到值得研究的问题,到用真实证据检验,再到把方法留给下一次。
把光标移到图上
DFM 关注的六项能力
- 01
识别有价值的未知
从尚未解释的现象、方法失效的地方和数据中的异常出发,判断哪些未知值得投入。
- 02
将未知转化为可研究的问题
把一个模糊的未知收敛为有边界、可切入、可检验的研究问题,并说明什么结果算作进展。
- 03
构建并修正研究假设
围绕问题提出假设,组织已有证据,并在新证据到来时修正或放弃假设。
- 04
调用科研工具、数据和实验环境
让假设离开文本:调用文献、代码、数据分析工具与实验环境,把判断变成可以执行的动作。
- 05
根据外部证据验证和更新判断
让系统的输出接受数据、实验、专家判断与现实环境的检验,并根据结果更新自己的判断。
- 06
沉淀可复用的研究结构与发现能力
把经过验证的问题、工具、数据与验证机制沉淀为可复用的结构,让每一次探索成为下一次发现的起点。
DFM 技术研究版图仓库呈现 Discovery Loop 的概念结构、研究方向、开源计划、Demo 和开发者协作机会。仓库中的研究目录和方向标记,是对未来研究范围的公开预留,不代表对应实现均已完成或发布。
03三个独立的研究与工程方向
ScienceBuddy、ScienceIDE 和 JEPA-Anything 是三个完全独立的模块与研究方向,在产品形态、使用方式、论文和技术实现上彼此独立,不存在必须的调用或依赖关系。
04独立研究方向·9 月 16 日
ScienceBuddyAI 科研搭档
可交互的 Scientific Agent:关注真实科研交互中的递归式自我改进,重点探索 Recursive-in-Recursive Self-Improvement(RSI in RSI)。
ScienceBuddy 是一项围绕科学家交互、科研反馈和智能体持续改进展开的独立研究与工程探索,与 DFM 所关注的 Discovery Intelligence 方向一致。
它重点探索一种交互式 Science RSI 形态:用户提出科学问题,智能体调用工具并给出回应;科学家的追问、修改、采纳、否定和重新运行形成反馈,进而推动科研智能体工作环境和 Harness 的持续演化。
ScienceBuddy 的产出不只是一次性的问答结果,也包括交互过程中的反馈、研究轨迹、工具调用和任务状态。这些信息未来可以进一步整理为可复用的科学任务和环境,用于强化学习或其他模型训练。
当前为早期产品 / 研究预览形态,具体开放能力、演示方式和使用入口以实际版本为准。产品入口于 9 月 16 日开放。
访问 ScienceBuddy9 月 16 日发布技术报告9 月 16 日发布GitHub9 月 16 日发布
科学家和 AI 搭档一问一答,追问、修改、采纳都被记下来,AI 的工作环境在一轮轮反馈里变好。
把光标移到图上
承接并结构化
- 科学问题
- 数据需求
- 研究材料
- 文献和代码
- 科研工具调用
- 假设形成与验证
- 后续科研工作流所需的信息
05独立研究方向·9 月 17 日
ScienceIDE科学集成开发平台
科学经验基础设施:关注真实科学代码、任务、环境和强化学习训练。
ScienceIDE 是一项面向真实科学代码库、研究任务和可验证科学经验的独立基础设施探索。
它把真实科学代码、研究流程、任务目标和验证标准转化为可运行、可测量、可复现的科学环境,让研究者能够在真实科学场景中开展 Agent 执行、模型训练和强化学习研究。
它的核心价值在于,把真实科学软件、领域判断、任务目标和可验证反馈组织到同一个可执行环境中,为科研 Agent、模型训练、强化学习和科学发现研究提供经验基础。ScienceIDE 不要求接入 ScienceBuddy 才能使用,也不依赖 JEPA-Anything 才能成立。
ScienceIDE 当前开放任务提案。项目主页、任务提交页面和代码仓库于 9 月 17 日按最终准备情况公开。
项目主页9 月 17 日发布技术报告9 月 17 日发布GitHub9 月 17 日发布
把一个真实的科研代码库变成一排可以运行、可以打分、可以重复的工作台,让 AI 在真实科学任务里做事并被检验。
把光标移到图上
当前任务形态
- 加速
- 发现
- 修复
- 复现
- 集成
06独立研究方向·9 月 18 日
JEPA-Anything跨领域统一科学世界模型
跨领域统一科学世界模型:面向跨领域状态预测、干预模拟和科学诊断。
JEPA-Anything 是一项面向潜在世界模型和正交预测因子分解的独立模型方法研究。
它探索如何在视觉、生物、临床、分子、控制和物理等不同领域中,学习能够预测世界状态变化的潜在表示,并为干预预测、状态合成和科学诊断提供统一接口。
在未来的研究愿景中,JEPA-Anything 可以被理解为面向多个科学环境的统一预测模型或科学世界模拟器:当研究者提出某种科学行为或干预时,模型预先预测可能的状态变化、结果和风险,帮助筛选无效或代价较高的方案。这是希望探索的能力方向:目前它并不能模拟所有科学环境,也尚未接入 ScienceBuddy 或 ScienceIDE。
论文、代码、模型权重和演示链接于 9 月 18 日按最终确认的开放范围公开。
论文9 月 18 日发布代码9 月 18 日发布演示9 月 18 日发布
在动手之前先预测:如果这样做,世界会变成什么样,哪条路值得走。
把光标移到图上
研究问题
- 如何表示复杂系统中的多种可预测因素
- 如何预测不同干预带来的状态变化
- 如何为实验选择和科学诊断提供预测依据
- 如何在跨领域场景中复用潜在世界状态接口
07可组合的研究路径
未来可能的组合路径
从未来愿景上看,三者可以形成一种可组合的研究路径:ScienceBuddy 通过科学家与智能体的交互收集反馈和研究轨迹;ScienceIDE 将这些数据和经验进一步组织为可复用的科学环境,用于任务执行、强化学习和模型训练;JEPA-Anything 则探索对多个科学环境和干预结果进行统一的状态预测和模拟。这是一种未来可能的组合方式,不代表三者当前已经完成集成,也不改变它们各自独立的定位。
- ScienceBuddy 与科学家持续交互,产生反馈、任务状态和科研轨迹
- ScienceIDE 把部分交互经验组织成可复用的科学环境,用于执行、训练和评估模型
- JEPA-Anything 探索对这些环境和潜在干预结果的统一状态预测,帮助研究者在行动前筛选方案
- 预测和真实实验结果作为新的证据,返回后续研究过程
这条路径表达的是三项独立工作的潜在协同价值,不是当前已经完成的产品集成路线,也不是三者未来必须合并为一个系统。
逐步实现,持续发布
DFM 是一套范式,不是一个已经完成的模型。围绕它的研究通过系统实例、独立论文、工程模块和真实科学合作逐步展开:9 月 15 日公开 DFM 技术报告与技术研究版图仓库;16、17、18 日分别发布 ScienceBuddy、ScienceIDE 与 JEPA-Anything。各项目的链接、代码与产品入口在对应日期开放,提前存在的链接一律标注为“即将发布”。
四日发布日历
- DFM 研究范式与 DFM 科学家合作计划
- ScienceBuddy · AI 科研搭档
- ScienceIDE · 科学集成开发平台
- JEPA-Anything · 跨领域统一科学世界模型