ScienceBuddy · AI 科研搭档
可交互的 Scientific Agent,探索真实科研交互中的 RSI in RSI
它重点探索一种交互式 Science RSI 形态:用户提出科学问题,智能体调用工具并给出回应;科学家的追问、修改、采纳、否定和重新运行形成反馈,进而推动科研智能体工作环境和 Harness 的持续演化。
访问 ScienceBuddy9 月 16 日发布

02为什么发起这个计划
今天的 AI 已经能够检索文献、生成代码、处理数据并辅助完成部分科研任务。但真正的科学发现,往往始于一个尚未被清晰定义的问题,并经历假设形成、证据组织、工具调用、实验验证以及持续修正。
这些过程无法只在标准数据集或封闭任务中完成。AI 需要进入真实科研环境,接触科学家真正关心的问题,理解不完整的数据与约束,并从实验和现实反馈中持续学习。
不预设所有问题都已被形式化,而是从科学家面对的未知、瓶颈与异常现象出发。
让模型输出接受数据、实验、专家判断与现实环境的检验。
沉淀可复用的问题、工具、数据与验证机制,让每一次探索成为下一次发现的起点。
科学家带来真实问题、数据和实验反馈,PhAI 带来模型、工具和分析,在真实实验里一起验证,结果回到科学家手里。
把光标移到图上
03什么是 DFM
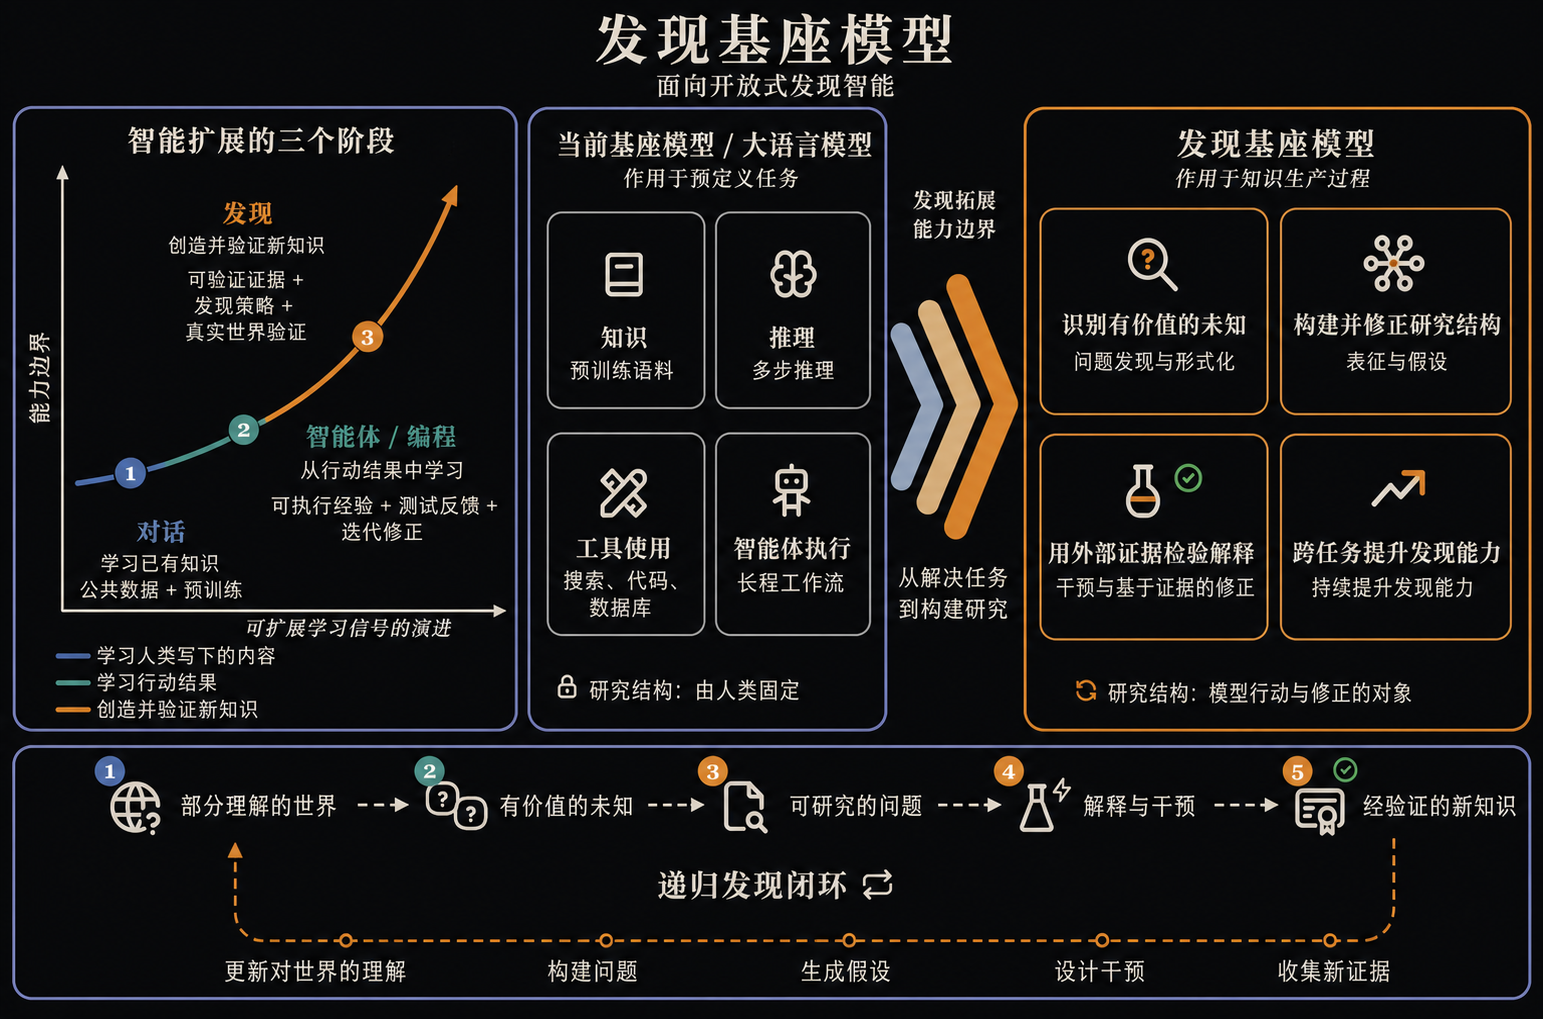
DFM(Discovery Foundation Models)不是一个单一模型,也不是要求所有系统按同一套流程运行的软件框架,而是 PhAI Labs 围绕 Discovery Intelligence 提出的一套研究范式、能力定义和系统组织方式。它通过形式化定义、流程图示、系统实例和真实科学案例,把“发现”从一个模糊概念具体化为一种可学习、可执行、可评测的模型系统能力。
DFM 科学家合作计划为这一范式引入真实科学问题、数据与验证条件,让系统在真实研究中形成判断。
三个独立的研究与工程方向
ScienceBuddy、ScienceIDE 和 JEPA-Anything 是三个完全独立的模块与研究方向,在产品形态、使用方式、论文和技术实现上彼此独立,不存在必须的调用或依赖关系。从未来愿景上看,三者可以形成一种可组合的研究路径:ScienceBuddy 通过科学家与智能体的交互收集反馈和研究轨迹;ScienceIDE 将这些数据和经验进一步组织为可复用的科学环境,用于任务执行、强化学习和模型训练;JEPA-Anything 则探索对多个科学环境和干预结果进行统一的状态预测和模拟。这是一种未来可能的组合方式,不代表三者当前已经完成集成,也不改变它们各自独立的定位。
可交互的 Scientific Agent,探索真实科研交互中的 RSI in RSI
它重点探索一种交互式 Science RSI 形态:用户提出科学问题,智能体调用工具并给出回应;科学家的追问、修改、采纳、否定和重新运行形成反馈,进而推动科研智能体工作环境和 Harness 的持续演化。
访问 ScienceBuddy9 月 16 日发布集成科学环境、代码、工具与训练流程的科学集成开发平台
它把真实科学代码、研究流程、任务目标和验证标准转化为可运行、可测量、可复现的科学环境,让研究者能够在真实科学场景中开展 Agent 执行、模型训练和强化学习研究。
ScienceIDE 项目主页9 月 17 日发布面向跨领域状态预测、干预模拟和科学诊断的统一科学世界模型
它探索如何在视觉、生物、临床、分子、控制和物理等不同领域中,学习能够预测世界状态变化的潜在表示,并为干预预测、状态合成和科学诊断提供统一接口。
JEPA-Anything 论文9 月 18 日发布04我们寻找什么
相比一个已被完整定义、只需要调用现成方法完成的任务,我们更关注那些具有真实科学价值、仍存在关键未知,并且能够获得数据或实验反馈的问题。
它可能帮助我们理解尚未解释的现象、发现新的机制或规律,或形成新的研究方法,而不只是对既有流程的小幅优化。
现有理论、模型、数据分析或实验方法还不能令人满意地回答它,并且失败原因本身值得研究。
已经存在一定的数据、文献、工具、实验条件或领域知识,使双方可以建立第一步探索。
系统提出的判断或假设,能够通过数据分析、实验、专家判断或真实环境被支持、修正或推翻。
可以从这些问题开始思考
05首期重点与合作对象
计划面向高校、科研机构、实验室和产业研发团队中的科学家及研究人员。问题可以处于早期构思、数据积累、方法受阻或实验验证阶段。
这些领域已经积累了大量多模态数据、专业工具和实验验证条件,同时仍存在大量复杂、开放且具有重要影响的科学问题。
我们希望与这样的研究者共同探索
你知道哪些问题真正重要,也了解现有方法的局限,希望把大模型、科研 Agent 或自动化实验更系统地接进研究流程。我们从具体的研究瓶颈出发,一起判断 AI 能在哪些环节发挥作用,并共同设计和验证方案。
你已经积累了专业数据、科研代码、计算模型或仿真环境,希望用 AI 拓展现有的分析与探索方法。我们一起看 AI 如何在其中开展可验证的研究任务。
你能开展实验、获得观测数据、检验假设,也想知道 AI 能否帮上实验设计、结果分析和下一步方向的选择。我们一起把从提出问题到获得证据的链路接成闭环。
希望把 AI 深度带入科研过程、愿意共同探索新研究范式的青年研究者。有持续关注的问题、相关的研究积累,或想一起探索的方向,都欢迎提出合作意向。
你在研究产品或工艺背后的科学问题,已有业务场景、数据积累或测试条件,但现有方法仍难以解释关键现象,或需要大量试验才能找到可行方案。我们一起识别其中适合 AI 参与的环节,结合实际研发要求,用计算、仿真或实验评估进展。
06合作方式
数据与知识产权进入实质性合作前,双方将通过书面协议明确数据使用范围、保密要求、成果发布、署名方式及知识产权安排。
07探索案例
首批种子用户正在将真实科研问题带入测试。我们将在获得相关研究者授权后,逐步公开具有代表性的探索过程、阶段结果与经验。
与其只展示最终答案,我们更希望呈现问题如何被定义、AI 参与了哪些环节、科学家如何判断和反馈,以及研究如何因此向前推进。
具身 AI 科学家的自主治疗发现
Generalizable Agentic Laboratory Intelligence for Learning, Experimentation, and Optimization
GALILEO 是 DFM 理念在生命科学领域的一次具象化实践:AI 不再是完成单个任务的工具,而是进入真实科研环境,从真实问题出发,在实验反馈中持续学习,参与科学发现的全过程。相关成果以预印本形式发于 bioRxiv(2026 年 6 月)。
现有 AI 系统在生物医学中大多停留在“预测”阶段,预测靶点、预测分子性质,却无法走到真实的实验干预。GALILEO 要回答的核心问题是:AI 能否走出预测,在动态膜系统中自主完成“从候选多肽发现到湿实验验证”的完整闭环,找到可干预肿瘤免疫的治疗性靶点与分子?
GALILEO 以 OTAS(Observation–Thought–Action–Summary,观察–思考–行动–总结)推理循环为核心,自主执行:
DFM 视角GALILEO 体现了 DFM 的核心主张:从“完成科研任务”走向“参与科学发现”。AI 进入真实科研环境,接触科学家真正关心的问题,理解不完整数据与约束,从实验和现实反馈中持续学习,让每一次探索成为下一次发现的起点。
08后续推进流程
说明科学问题、已有进展、关键瓶颈,以及可以提供的数据或验证条件。
综合科学价值、AI 参与空间、数据与验证条件,以及双方资源匹配度进行判断。
PhAI Labs 与申请方进一步理解问题背景、合作诉求与现有研究基础。
明确研究目标、工作路径、人员投入、数据使用方式和阶段验证标准。
进入早期验证或深入共研,并根据真实反馈持续迭代和推进。
09常见问题
我们优先关注具有明确科学价值、仍存在关键未知、AI 有实质参与空间,并能够获得数据、实验或专家反馈的问题。问题不需要已经完全形式化,但应当能够说明为什么重要,以及第一步可以从哪里开始。
可以。识别有价值的未知并把它转化为可研究的问题,本身就是 DFM 希望参与的环节。申请时请尽量说明观察到的现象、现有方法的局限,以及目前掌握的线索或条件。
我们倾向于先围绕一个边界清晰的子问题开展早期验证,确认问题建模、数据条件、AI 参与方式和验证路径是否成立,再决定是否进入更深入的联合研究。具体范围和节奏由双方共同设计。
主要考虑科学问题的重要性、DFM 与科研 Agent 能否带来新的研究增量、数据或验证条件是否可行,以及双方在当前阶段能否投入匹配的研究与工程资源。
成果不预设为单一形式,可能包括经过验证的新假设、可复用的研究流程、工具或数据资产、模型与 Agent 能力改进,也可能进一步形成论文、开源项目或其他联合成果。
请勿直接上传患者隐私、临床敏感信息、受第三方限制的数据、未确认授权的材料或其他需要保密审查的内容。进入进一步沟通后,双方再确认合适的数据交换和保护方式。
10立即申请
不需要先把问题整理成完整的项目方案。请先告诉我们:你真正想理解的未知是什么,为什么它重要,目前的研究进展和主要困难是什么,以及已经具备哪些数据、工具或验证条件。
立即申请 飞书问卷
请勿在首次申请中直接上传患者隐私、临床敏感信息、受第三方限制的数据或其他尚未确认使用权限的材料。